StudyMate
GenAI Powered Study Assistant with RAG, semantic search, and contextual PDF summarization.
Overview
A document intelligence application that leverages Retrieval Augmented Generation (RAG), semantic search, embeddings, and ChromaDB for contextual PDF summarization and question answering. Tuned retrieval pipelines with LLM and Hugging Face models enable 40% faster document review and 70% reduced review effort.
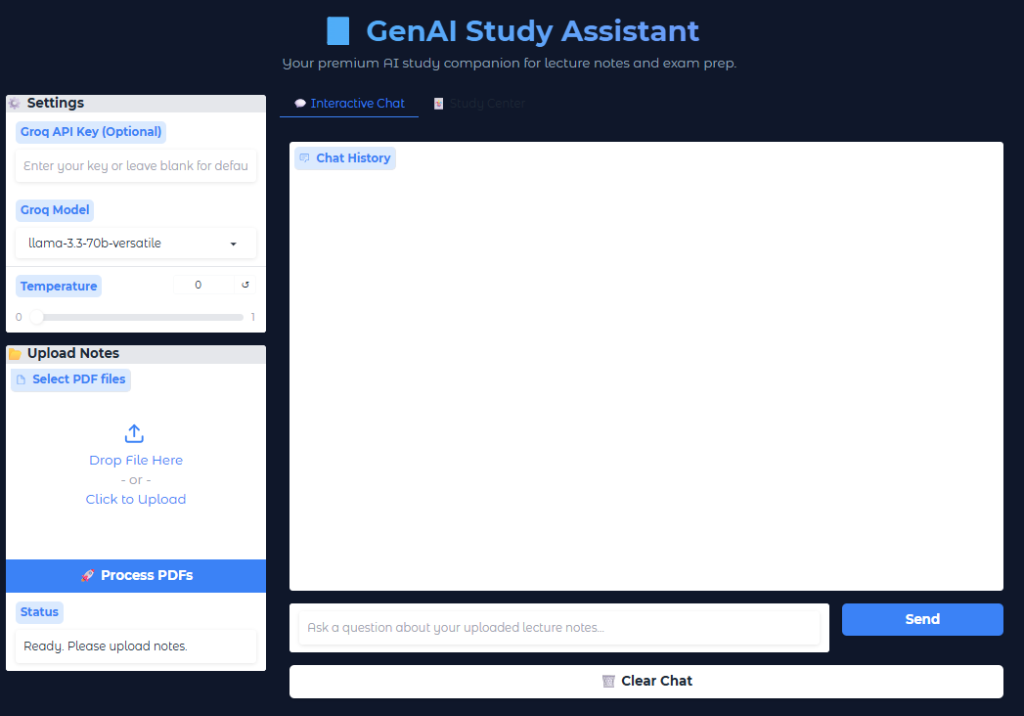
// System Diagnostics & Performance Metrics
// Core Pipeline & Systems Architecture Flow
Sequential data ingestion, processing, representation model routing, and generation steps.
PDF Ingestion
Parser extracts raw text and elements from document upload.
Semantic Chunking
Recursively chunks document text with dynamic overlap size.
Embedding Generation
Hugging Face embeddings map text chunks into vector coordinates.
ChromaDB Storage
Saves high-dimensional vectors for fast semantic query retrieval.
RAG Context Retrieval
Filters relevant context chunks using cosine similarity.
LLM Orchestration & Guardrails
Injects context and query into Groq/Gemini, validated via LlamaGuard.
Technical Obstacles
Processing dense, multi-format PDFs introduced noise, high LLM token costs, and slow response times due to unoptimized chunking strategies.
Engineering Solution
Built a custom chunking pipeline using LangChain's recursive character text splitter. Cached semantic embeddings in ChromaDB to reduce LLM API roundtrips, and added a context routing mechanism to choose the best retriever.